

Bénéficiez de toutes les fonctionnalités d’un CDN moderne : une scalabilité transparente, une sécurité intégrée, un contrôle par programmation et une visibilité totale.



Qu’est-ce qu’un fichier robots.txt ?
Le fichier robots.txt se trouve dans le répertoire d’un site web et fournit aux bots des règles indiquant quelles pages ou quels fichier doivent être consultés. Il fonctionne comme un ensemble de directives que les propriétaires de sites web utilisent pour contrôler la façon dont les moteurs de recherche et les autres bots interagissent avec leurs sites web.
Pourquoi le fichier robots.txt est important
Le fichier Robots.txt a un impact direct sur l’optimisation pour les moteurs de recherche d’une organisation et sur le classement des pages dans les résultats de recherche. Les robots d’exploration légitimes consultent le fichier Robots.txt chaque fois qu’ils explorent et indexent du contenu. De plus, des moteurs de recherche populaires comme Googlebot disposent également de ce que l’on appelle un budget de crawl, et le fichier Robots.txt l’influence directement. Le budget de crawl fait référence au nombre de pages qu’un web scraper indexera sur une période donnée. Comme un site web peut comporter plus de pages que ne le permet son budget de crawl, les fichiers robots.txt permettent aux organisations de prioriser l’exploration de leurs pages les plus pertinentes et d’exclure les pages en double ou non publiques.
Les bots de scraping malveillants ne respectent pas les directives du fichier robots.txt et tentent souvent d’accéder à des parties du site web qui y sont explicitement interdites. Considérez les fichiers robots.txt comme des lignes tracées dans le sable pour tenir les bots légitimes en respect. Bien que vous puissiez suivre ses directives, les enfreindre relève simplement d’une décision éthique et n’est en aucun cas limité par les règles du fichier robots.txt elles-mêmes. Cependant, les applications exécutent généralement d’autres outils de sécurité, ce qui leur permet d’ajouter une protection à leur application et à ses fichiers ou répertoires sensibles. De nombreux outils de sécurité surveillent attentivement les fichiers robots.txt, car ils peuvent être utilisés comme honeypot pour piéger rapidement les bots malveillants sur leurs applications !
Comment créer un fichier robots.txt
Il y a quelques points à prendre en compte lors de la création de fichiers robots.txt :
Le fichier doit être situé à la racine du domaine, et chaque sous-domaine doit avoir son propre fichier.
Le protocole robots.txt est sensible à la casse.
Il est facile de bloquer accidentellement toute exploration, alors assurez-vous de bien comprendre la syntaxe d’une commande avant de l’implémenter :
Disallow: / signifie tout interdire.
Disallow: signifie ne rien interdire, ce qui autorisera tout.
Allow : / signifie tout autoriser.
Allow: signifie ne rien autoriser, ce qui interdira tout.
Voici un exemple de fichier robots.txt Basic :
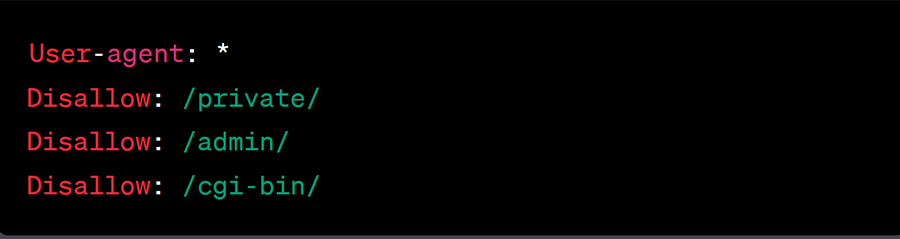
Dans cet exemple, l’astérisque (*) dans le champ "Agent utilisateur" indique que les règles s’appliquent à tous les robots web. Le code "Disallow" indique les répertoires ou fichiers que les robots ne doivent pas explorer, et "/private/," "/admin/," et "/cgi-bin/" sont les répertoires non autorisés spécifiés. En utilisant cette logique, les admins peuvent définir clairement les emplacements que les bots ne doivent pas explorer, et ils peuvent l’étendre à autant d’emplacements que souhaité.
Le fichier robots.txt permet aux organisations de décider quelles pages un robot d’exploration peut consulter, mais il peut aussi limiter la vitesse à laquelle un robot d’exploration fonctionne. Le crawl delay est une directive non officielle que les organisations peuvent utiliser pour limiter le nombre de requêtes qu’un robot d’exploration effectue sur une période donnée. Cela limite la capacité d’un robot d’exploration à submerger un serveur, et les organisations peuvent mettre en œuvre un crawl delay pour un robot d’exploration particulier, ou pour tous ceux qui prennent en charge la directive. Il est important de noter que, si des moteurs de recherche comme Yahoo et Bing suivent cette directive non officielle, d’autres (comme Googlebot) nécessiteront des ajustements dans leurs consoles respectives pour obtenir le même résultat.
Résumé
Les propriétaires de sites web créent le fichier robots.txt pour guider les bots sur leurs applications. Bien que les bots légitimes utilisent ces informations pour savoir quelles pages explorer, les bots de scraping malveillants l’ignorent et explorent où bon leur semble. Apprenez-en davantage sur les types de bots concernés par les fichiers robots.txt ici.