

Consigue todo lo que necesitas de una CDN moderna: desde seguridad integrada y escalabilidad sin trabas hasta control programable y visibilidad total.



¿Qué es un archivo robots.txt?
El archivo robots.txt se encuentra en el directorio de un sitio web y proporciona a los bots reglas sobre qué páginas o archivos deben consultarse. Funciona como un conjunto de directrices que los propietarios de sitios web utilizan para controlar cómo los motores de búsqueda y otros bots interactúan con sus sitios web.
La importancia del archivo robots.txt
El archivo Robots.txt afecta directamente a la optimización en buscadores de una organización y a la clasificación de sus páginas en los resultados de búsqueda. Los extractores legítimos consultan el archivo Robots.txt cada vez que extraen e indexan contenido. Asimismo, los buscadores populares como Googlebot también tienen lo que se conoce como un presupuesto de rastreo, y el archivo Robots.txt influye directamente en él. Un presupuesto de rastreo se refiere al número de páginas que un rastreador web indexará en un periodo de tiempo determinado. Como es posible que un sitio web tenga más páginas de las que permite su presupuesto de rastreo, los archivos robots.txt permiten a las organizaciones priorizar el rastreo de sus páginas más relevantes y excluir las duplicadas o no públicas.
Los bots de extracción maliciosos no respetan las directrices de robots.txt y a menudo intentan acceder a partes del sitio web que están expresamente prohibidas en él. Piensa en los archivos robots.txt como líneas en la arena trazadas para mantener a raya a los bots legítimos. Aunque puedes seguir sus directrices, cruzarlas es simplemente una decisión ética y no está restringido en modo alguno por las propias reglas de robots.txt. Sin embargo, las aplicaciones suelen ejecutar otras herramientas de seguridad que les permiten añadir protección a la aplicación y a sus archivos o directorios sensibles. Muchas herramientas de seguridad prestan mucha atención a los archivos robots.txt, ya que pueden usarse como señuelo para atrapar rápidamente bots maliciosos en sus aplicaciones.
Creación de un archivo robots.txt
Hay varios aspectos que se deben tener en cuenta a la hora de crear archivos robots.txt:
El archivo debe estar ubicado en la raíz del dominio y cada subdominio necesita su propio archivo.
El protocolo de robots.txt distingue entre mayúsculas y minúsculas.
Resulta fácil bloquear totalmente el rastreo sin querer, así que asegúrate de entender la sintaxis de un comando antes de implementarlo:
Disallow: / lo prohíbe todo.
Disallow: no prohíbe nada; es decir, lo permite todo.
Allow: / lo permite todo.
Allow: no permite nada; es decir, lo prohíbe todo.
A continuación tenemos un ejemplo de un archivo robots.txt básico:
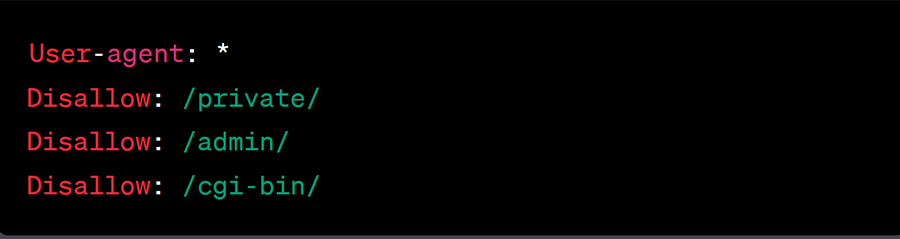
En este ejemplo, el asterisco (*) del campo "User-agent" indica que las reglas se aplican a todos los robots web. El código "Disallow" especifica los directorios o archivos que no deberían rastrear los robots, y "/private/", "/admin/" y "/cgi-bin/" son los directorios prohibidos especificados. Siguiendo esta lógica, los administradores pueden estipular exactamente lo que los bots no deberían rastrear y lo pueden extender a tantas ubicaciones como deseen.
El archivo robots.txt permite a las organizaciones decidir a qué páginas puede acceder un rastreador, pero también puede limitar la rapidez con la que funciona. El retraso de rastreo es una directiva extraoficial que las organizaciones pueden utilizar para limitar el número de peticiones que haga un rastreador durante un periodo de tiempo. Esto limita la capacidad de un rastreador para saturar un servidor, y las organizaciones pueden implementar un retraso de rastreo para un rastreador concreto o para todos los que admitan la directiva. Es importante tener en cuenta que, aunque motores de búsqueda como Yahoo y Bing seguirán esta directiva extraoficial, otros (como Googlebot) requerirán ajustes en sus consolas específicas para lograr el mismo resultado.
Resumen
Los propietarios de sitios web crean el archivo robots.txt para guiar a los bots por sus aplicaciones. Mientras que los bots legítimos usan esta información para saber qué páginas rastrear, los bots maliciosos de extracción la ignoran y rastrean donde les place. Aquí encontrarás más información acerca de los tipos de bots a los que afectan los archivos robots.txt.