

簡単なスケーリングや組み込みのセキュリティ、プログラマブルなコントロール、完全な可視性まで、Fastly は最先端の CDN に求められるあらゆる機能を提供します。



robots.txt ファイルとは何ですか?
robots.txt ファイルは、Webサイトのディレクトリ内に置かれ、アクセスすべきページやファイルに関するルールをボットに提供します。これは、Webサイトの所有者が検索エンジンやその他のボットが自社のWebサイトとどのようにやり取りするかをコントロールするために使用する一連のガイドラインとして機能します。
robots.txt ファイルが重要な理由
robots.txt ファイルは、組織の検索エンジン最適化と検索結果でのページランキングに直接影響します。正当なスクレイパーは、コンテンツをスクレイピングしてインデックス化するたびに robots.txt ファイルを参照します。さらに、Googlebot のような一般的な検索エンジンにもクロールバジェットと呼ばれるものがあり、robots.txt ファイルはそれに直接影響します。クロールバジェットとは、Web スクレイパーが一定期間内にインデックス化するページ数を指します。Webサイトにはクロールバジェットで考慮される数を超えるページが含まれる場合があるため、robots.txt ファイルを使用すると、組織は最も関連性の高いページのクロールを優先し、重複ページや非公開ページを除外できます。
悪意のあるスクレイパーボットは robots.txt のガイドラインに従わず、Webサイト内で明示的に禁止されている部分へのアクセスを試みることがよくあります。robots.txt ファイルは、正当なボットを抑制するために引かれた一線のようなものだと考えてください。そのガイドラインに従うことはできますが、それを越えるかどうかは単なる倫理的な判断であり、robots.txt のルール自体によって何ら制限されるものではありません。ただし、アプリケーションは通常、他のセキュリティツールも実行しており、それによってアプリケーションとその機密性の高いファイルやディレクトリに保護を追加できます。robots.txt ファイルは、アプリケーション上で悪意のあるボットを素早く捕まえるためのハニーポットとして使用できるため、多くのセキュリティツールがこれに細心の注意を払っています!
robots.txt ファイルの作成方法
robots.txt ファイルを作成する際、留意すべき点がいくつかあります。
ファイルはドメインのルートに配置する必要があり、各サブドメインにはそれぞれ専用のファイルが必要です。
robots.txt プロトコルは大文字と小文字を区別します。
誤ってすべてのクローリングをブロックしてしまいやすいため、実装する前にコマンドのシンタックスを必ず理解してください:
「Disallow: /」はすべてを拒否することを意味します。
「Disallow:」は何も拒否しないことを意味し、その結果、すべてが許可されます。
「Allow: /」はすべてを許可することを意味します。
「Allow:」は「何も許可しない」すなわちすべて拒否することを意味します。
以下は基本的な robots.txt ファイルの例です。
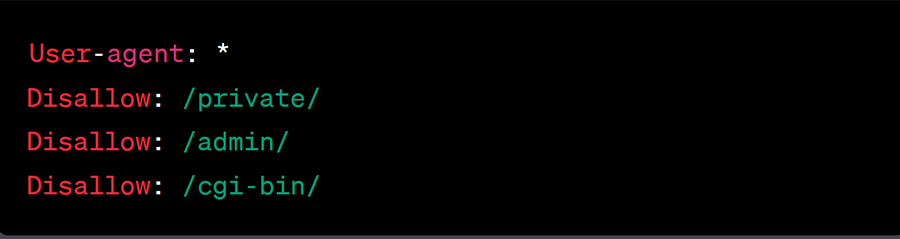
この例では、「User-agent」フィールドのアスタリスク(*)は、ルールがすべての Web ロボットに適用されることを示しています。「Disallow」コードは、ロボットがクロールすべきではないディレクトリまたはファイルを指定し、「/private/」、「/admin/」、「/cgi-bin/」が指定されたクロール禁止ディレクトリです。このロジックを使用すると、管理者はボットがクロールすべきでない場所を正確に指定でき、必要なだけ多くの場所に拡張できます。
robots.txt ファイルを使用すると、組織はクローラーがアクセスできるページを決定できますが、クローラーの動作速度を制限することもできます。crawl delay は、一定期間内にクローラーが行うリクエスト数を制限するために組織が使用できる非公式のディレクティブです。これにより、クローラーがサーバーに過負荷をかける能力が制限され、組織は特定の 1 つのクローラー、またはこのディレクティブをサポートするすべてのクローラーに対して crawl delay を実装できます。Yahoo や Bing などの検索エンジンはこの非公式のディレクティブに従いますが、他の検索エンジン(Googlebot など)では、同じ結果を得るためにそれぞれ固有のコンソールで調整が必要になる点に注意することが重要です。
概要
Webサイトの所有者は、アプリケーション上でのボットの動作を制御するために robots.txt ファイルを作成します。正当なボットはこの情報に基づいてどのページをクローリングすべきか判断しますが、悪意のあるスクレーパー・ボットはこれを無視して好き勝手にクローリングします。robots.txt ファイルの影響を受けるボットの種類について詳しくはこちらをご覧ください。